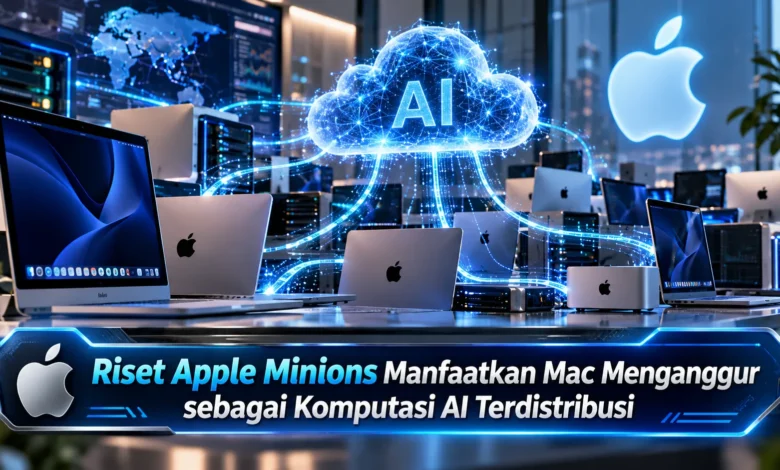
Apple mengembangkan pendekatan baru untuk memanfaatkan komputer Mac yang sedang tidak digunakan melalui sistem komputasi terdistribusi bernama Minions. Penelitian yang dipublikasikan pada Oktober 2026 ini memperlihatkan bagaimana GPU pada perangkat berbasis Apple Silicon dapat digabungkan menjadi sumber daya komputasi virtual untuk menjalankan tugas kecerdasan buatan. Inovasi TEKNOLOGI tersebut bertujuan mengurangi ketergantungan terhadap infrastruktur GPU terpusat yang sering menghadapi antrean pekerjaan dan biaya operasional tinggi. Dengan memanfaatkan kapasitas perangkat yang sudah tersedia, Minions menawarkan cara berbeda dalam mengelola inferensi AI, meningkatkan efisiensi penggunaan perangkat keras, dan mendistribusikan pekerjaan komputasi.
Mengenal Riset Apple Minions untuk Komputasi GPU Terdistribusi
Perkembangan ekosistem komputasi AI mendorong pertumbuhan penggunaan sumber daya komputasi yang dirancang memproses berbagai aplikasi AI generatif. Pada pendekatan konvensional, tugas inferensi biasanya dijalankan melalui infrastruktur khusus. Meskipun pusat data menyediakan daya komputasi tinggi, ketersediaan perangkat GPU tidak selalu mencukupi. Permasalahan tersebut mungkin menghambat penyelesaian tugas ketika permintaan inferensi meningkat. Untuk mengatasi persoalan tersebut, peneliti Apple mengembangkan sistem Minions yang menggabungkan kapasitas pemrosesan perangkat Apple Silicon.
Pengembangan ini dipaparkan pada penelitian berjudul Minions: A Dynamic and Distributed Virtual GPU Cloud Built on Idle Apple Silicon Devices yang dipublikasikan pada Oktober 2026. Publikasi dari tim Apple tersebut menjelaskan cara mengumpulkan kemampuan GPU perangkat Mac menjadi sebuah cloud GPU virtual. Daripada menambah server khusus untuk setiap kebutuhan, organisasi mampu memanfaatkan kapasitas komputasi yang belum terpakai. Konsep komputasi terdistribusi tersebut diharapkan membantu memperbaiki efisiensi operasional. Walaupun konsepnya menjanjikan, Minions belum menjadi layanan publik untuk seluruh pemilik Mac.
Cara Kerja Sistem Minions dalam Membagi Pekerjaan AI
Platform komputasi terdistribusi Apple menggunakan pendekatan pengumpulan sejumlah komputer Apple Silicon yang sedang tidak menjalankan pekerjaan berat. Saat pengguna mengajukan permintaan komputasi, sistem memecah permintaan ke dalam sejumlah subtugas. Bagian pekerjaan yang dihasilkan kemudian diproses oleh Mac yang memiliki sumber daya. Berkat distribusi pekerjaan tersebut, beberapa komputer dapat berkontribusi pada beban kerja bersama. Setelah pemrosesan selesai, keluaran disimpan untuk digunakan lebih lanjut. Selanjutnya, sistem menyelesaikan pekerjaan berdasarkan subtugas yang telah diproses.
Aspek teknis utama Minions adalah pendekatan pembagian tugas ketika perangkat mengambil pekerjaan sendiri. Tidak seperti penjadwalan yang sepenuhnya mengandalkan perintah pengiriman, komputer yang memiliki kapasitas menganggur mengakses daftar pekerjaan yang menunggu. Mekanisme pengambilan pekerjaan tersebut memberikan fleksibilitas ketika kapasitas komputasi berubah. Sebagai contoh, sebuah Mac mungkin tersedia ketika pengguna sedang beristirahat. Ketika perangkat kembali sibuk, sistem membutuhkan mekanisme pengelolaan kapasitas yang berubah. Dengan pertimbangan tersebut, pengelolaan perangkat yang berubah-ubah sangat diperlukan.
Bagaimana Apple Mengelola Pekerjaan GPU di Banyak Mac
Dalam arsitektur Minions, Apple menggunakan beberapa komponen, termasuk Minion Server, Minion Executor, dan Minion Watchdog. Layanan koordinasi Minions berperan dalam membagi permintaan komputasi menjadi unit kerja yang lebih kecil. Adapun pada komputer Mac, Minion Executor mengelola pelaksanaan subtugas pada mesin lokal. Executor pada masing-masing Mac menggunakan kemampuan akselerasi grafis perangkat untuk memproses data yang diberikan. Layanan watchdog sistem digunakan untuk mendukung keandalan eksekusi agar operasional sistem tetap dapat dipantau.
Penelitian tersebut, basis data PostgreSQL digunakan untuk mencatat subtugas. Pertukaran informasi tugas dilakukan melalui layanan REST. Untuk mendukung distribusi data, Amazon S3 digunakan sebagai penyimpanan objek. Saat executor mengambil pekerjaan, komputer tersebut mengambil data yang diperlukan dan menyiapkan model pembelajaran mesin. Ketika komputasi berhasil dilakukan, hasil dikirim kembali ke penyimpanan. Arsitektur berbasis komponen ini mendukung pemisahan koordinasi dan eksekusi.
Keunggulan GPU Mac untuk Menjalankan Inferensi Kecerdasan Buatan
Pemilihan perangkat Mac berbasis Apple Silicon memanfaatkan akselerator grafis bawaan perangkat. Perangkat Apple Silicon memiliki GPU yang dapat menjalankan komputasi AI. Pada penggunaan komputer yang tidak membutuhkan grafis berat, sebagian kemampuan akselerasi mungkin tetap menganggur. Pendekatan penelitian ini mencoba menggunakan kapasitas yang belum terpakai untuk melaksanakan tugas pembelajaran mesin. Melalui pengelolaan terdistribusi, organisasi memiliki alternatif sumber daya AI tanpa harus memperbesar pusat data untuk semua tugas.
Dalam membaca hasil penelitian ini, penting diketahui bahwa Minions dirancang menjalankan tahap penggunaan model AI, bukan sistem pelatihan AI skala besar sebagai kemampuan utama saat ini. Inferensi sendiri merupakan proses menjalankan model untuk menghasilkan prediksi atau respons. Pada pekerjaan yang ditangani sistem, salah satu tugas yang didukung adalah pembuatan embedding menggunakan jaringan neural transformer yang tersedia secara terbuka. Tidak hanya memproses embedding, Minions menjalankan pembuatan teks menggunakan LLM dengan memanfaatkan perangkat lunak Ollama pada perangkat yang berpartisipasi. Pilihan tugas inferensi ini memperlihatkan jenis pekerjaan yang diuji secara lebih jelas.
Potensi Penghematan Sumber Daya dengan Komputasi Terdistribusi Apple
Motivasi penting pengembangan Minions adalah antrean penggunaan server pemrosesan kecerdasan buatan. Saat sejumlah tim membutuhkan komputasi secara serentak, akses terhadap perangkat keras bisa menjadi terbatas. Dalam pengalaman operasional yang dibahas, sejumlah permintaan komputasi mengalami penundaan selama lebih dari sepuluh jam. Setelah menggunakan kapasitas perangkat yang tersedia, waktu tunggu untuk beberapa tugas dapat turun hingga hitungan menit. Namun demikian, manfaat waktu tunggu dapat berbeda menurut jenis inferensi. Ketersediaan GPU tetap memengaruhi hasil.
Di samping meningkatkan fleksibilitas pemrosesan, Minions berpotensi meningkatkan pemanfaatan investasi perangkat keras. Mesin macOS yang sudah digunakan tim biasanya dibeli untuk kebutuhan kerja tertentu. Ketika perangkat tidak aktif secara intensif, kapasitas komputasi dapat dipakai untuk tugas terdistribusi. Meskipun memanfaatkan aset yang sudah ada, efisiensi ekonominya tetap perlu dihitung. Penggunaan listrik, pemeliharaan perangkat, dan kebutuhan menjaga kenyamanan penggunaan Mac harus diperhatikan. Apabila manfaatnya terbukti secara nyata, pendekatan Minions dapat membantu memaksimalkan aset komputasi.
Privasi Data serta Keandalan Jaringan GPU Virtual Apple
Kendati pendekatan Apple memiliki sejumlah manfaat, keamanan dan privasi tetap menjadi perhatian penting. Saat tugas dipindahkan ke perangkat dari tim berbeda, pengelolaan izin menjadi semakin penting. Pada laporan penggunaan sistem tersebut, sebagian tim mempertanyakan keamanan pemrosesan data di perangkat kelompok lain. Kekhawatiran tersebut menunjukkan pentingnya pengendalian akses. Mekanisme seperti verifikasi identitas node, pengaturan akses terhadap data, serta audit penggunaan sumber daya. Apabila kontrol keamanan diabaikan, efisiensi sistem dapat dibayangi persoalan keamanan informasi.
Dalam penelitian berikutnya, tim Apple membuka kemungkinan perluasan sistem dari inferensi menuju pekerjaan pembelajaran mesin yang lebih kompleks. Perlu dipahami bahwa, arah pengembangan itu belum berarti Minions telah mendukung semua tugas training. Makalah tersebut turut mempertimbangkan kemungkinan membangun jaringan komputasi lintas lingkungan apabila perlindungan data dapat dijamin secara memadai. Peluang pengembangan ini membuka kemungkinan pengumpulan GPU dalam skala besar. Kendati menjadi arah penelitian yang relevan, partisipasi komputer pribadi secara global belum menjadi kemampuan publik. Kelayakan penerapan yang lebih luas ditentukan oleh kemampuan mengelola sistem yang semakin kompleks.
Kesimpulan: Apple Minions Membuka Peluang Komputasi AI yang Lebih Efisien
Penelitian Apple Minions memberikan gambaran baru dalam pengembangan sistem pemrosesan yang lebih fleksibel. Dengan menggabungkan GPU Mac yang menganggur, Minions dapat meningkatkan pemanfaatan perangkat keras tanpa mengandalkan perluasan pusat data pada setiap kebutuhan. Pemrosesan berbasis perangkat yang mengambil tugas sendiri menjadi dasar penting ketika jumlah node yang aktif berfluktuasi. Kendati menawarkan peluang efisiensi, penggunaan dalam skala lebih luas memerlukan pengujian lanjutan. Tidak kalah penting, sistem ini belum menjadi layanan publik bagi seluruh pemilik Mac. Bagaimana pendapat Anda mengenai riset Apple Minions? Silakan bagikan pendapat Anda mengenai peluang memanfaatkan perangkat yang sudah tersedia untuk kebutuhan kecerdasan buatan.